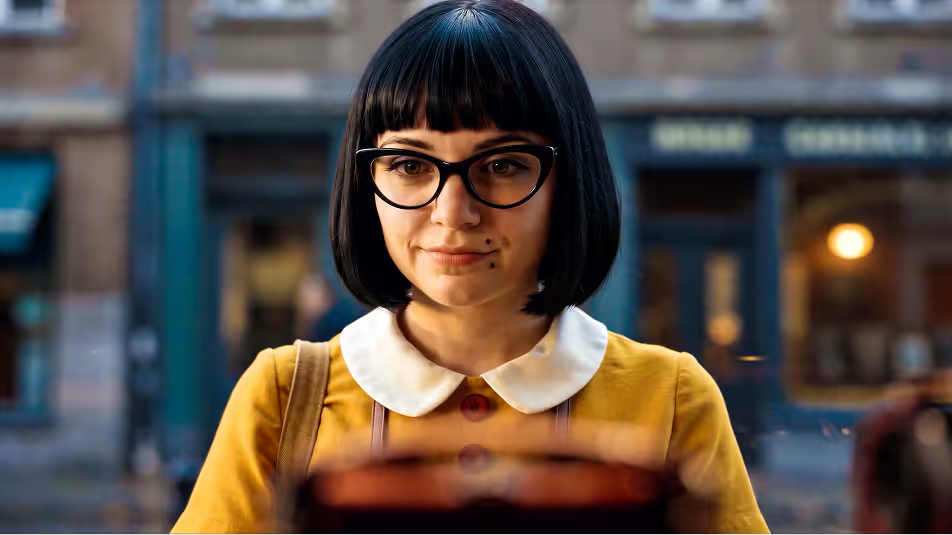معظم أدوات الفيديو بالذكاء الاصطناعي مصممة للقطات البارزة. Sora، Kling، Luma، Runway—كلها محسّنة للحظة المشهد المذهل: مقطع قصير من خمس ثوانٍ، تجربة بصرية تبدو مثيرة للإعجاب على وسائل التواصل الاجتماعي.
ما لا تحله هذه الأدوات غالبًا هو الجزء المهم فعلاً لرواة القصص المحترفين: الاتساق بين المشاهد، هوية الشخصية عبر القطع، والتحكم الإبداعي الدقيق الذي لا يتطلب البدء من جديد في كل مرة يكون فيها شيء غير دقيق.
هذه هي الفجوة التي تستهدفها Utopai Studios مع PAI. فريقها، المكوّن من باحثين من Google Research وMeta Superintelligence وAmazon AGI وAdobe Firefly، بنى PAI خصيصًا للإنتاج السينمائي الطويل: حتى 16 لقطة في تدفق سردي واحد، مخرجات تصل إلى دقيقة واحدة، ودقة تصل إلى 4K.
كما يتضمن حماية مدمجة لحقوق النشر تمنع التوليد ضد الملكية الفكرية المحمية والشخصيات المحمية بحقوق النشر والمظاهر العامة الحقيقية—وهي ميزة تستهدف الاستوديوهات والمحترفين الذين لا يمكنهم تحمل انتهاك غير مقصود.
فتح PAI للجمهور في وقت سابق من هذا الشهر. دخلنا إليه، وقضينا وقتًا في كل مرحلة من مراحل سير العمل، وفقدنا بعض الرصيد في هذه العملية. إليكم الصورة الكاملة.

تبدو الشاشة الرئيسية مثل ChatGPT أو أي واجهة دردشة نموذجية. من هناك، تتنقل بين خمس علامات تبويب: الشخصيات، القصة المصورة، الفيديو، المحرر، والسجل.
لكن لا تدع هذا يخدعك: PAI ليس أداة تعتمد على كتابة الأمر والانتظار مثل Sora أو Veo. إنه خط إنتاج منظم مع طبقة لغة طبيعية فوقه، والفرق مهم—جدًا—عندما تكون الرصيد على المحك.
هذه هي أقوى ميزة في المجموعة بأكملها، وربما أكثر نظام توليد شخصيات إثارة للإعجاب المتاح حاليًا في أي أداة فيديو بالذكاء الاصطناعي.
يمكن للمستخدمين إما السماح للنموذج بإنشاء شخصيات من تلقاء نفسه أو تزويده بصور مرجعية للعمل منها. ما يفعله ليس تبديل الوجوه—فهو لا ينقل ملامح شخص حقيقي كما تفعل أدوات التزييف العميق. بدلاً من ذلك، يولد نماذج جديدة تمامًا قريبة جدًا من المرجع، دون المشاكل القانونية والأخلاقية التي تأتي مع استبدال الوجه المباشر. جميع المخرجات موقعة بعلامة SynthID.

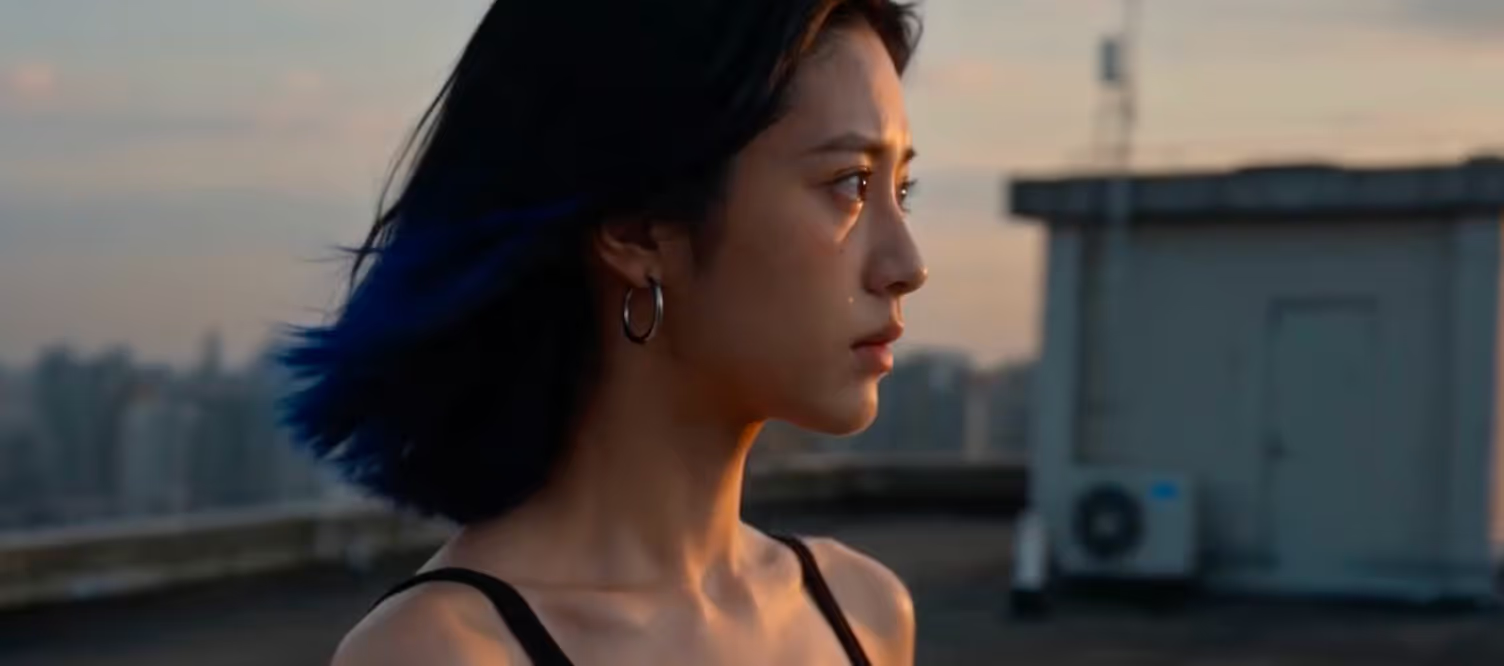
معظم الشخصيات المولدة بالذكاء الاصطناعي لها جودة جلد شمعية تكشفها فورًا. شخصيات PAI ليست كذلك، أو على الأقل ليس بنفس المستوى. ملمس الجلد يبدو واقعيًا، وكذلك طريقة تفاعل الضوء مع الوجه، والتفاصيل قوية. سواء كان ذلك من نموذج خاص أو سير عمل توليد محسّن بشكل غير عادي، النتائج تتحدث عن نفسها.
تحرير الشخصية يتم من خلال اللغة الطبيعية: قمت بتوليد شخصية باستخدام مظهر زوجتي كمرجع، لكن وجدت النتيجة نحيفة جدًا—لذلك طلبت من النموذج تعديل نسب الجسم لتطابق المرجع بشكل أفضل. لقد فهم تمامًا ما قصدته وصححه.
التحذير الوحيد المتكرر: إنه بطيء. حتى توليد صورة شخصية أساسية يستغرق بضع دقائق لكل تشغيل.
يمكنك تشغيل القصة المصورة على الوضع التلقائي والسماح للنموذج بفعل كل شيء، لكن هذا ليس ما صُمم من أجله.
يكافئ PAI الإدخال المفصل هنا. كلما شرحت أكثر—ماذا تفعل الشخصيات في كل مشهد، وماذا يقولون، وكيف تتحرك القصة—كلما عمل النموذج بشكل أفضل. زوده بتلك الخصوصية وسيستخدم الذكاء الاصطناعي لتوسيع التفاصيل، ثم يبني حوالي اثني عشر إطارًا رئيسيًا. يأتي كل إطار مع صورة مشهد ووصف لما يحدث في تلك اللحظة بالضبط: حركات الشخصيات، الحوار، والتكوين البصري.

يمكنك تعديل كل إطار رئيسي بشكل فردي قبل الالتزام بأي شيء. التحكم دقيق حقًا. بمجرد أن تكون راضيًا، تخبر النموذج بالمتابعة، ويطلب تأكيدًا نهائيًا قبل العرض. هذا التدفق للمراجعة قبل العرض هو تصميم ذكي. إنه يفرض قرارات مدروسة ويلتقط المشاكل قبل أن تصبح مكلفة.
ومع ذلك، حتى أصغر تعديل يستغرق وقتًا ويستهلك رصيدًا. تحرك بحذر.
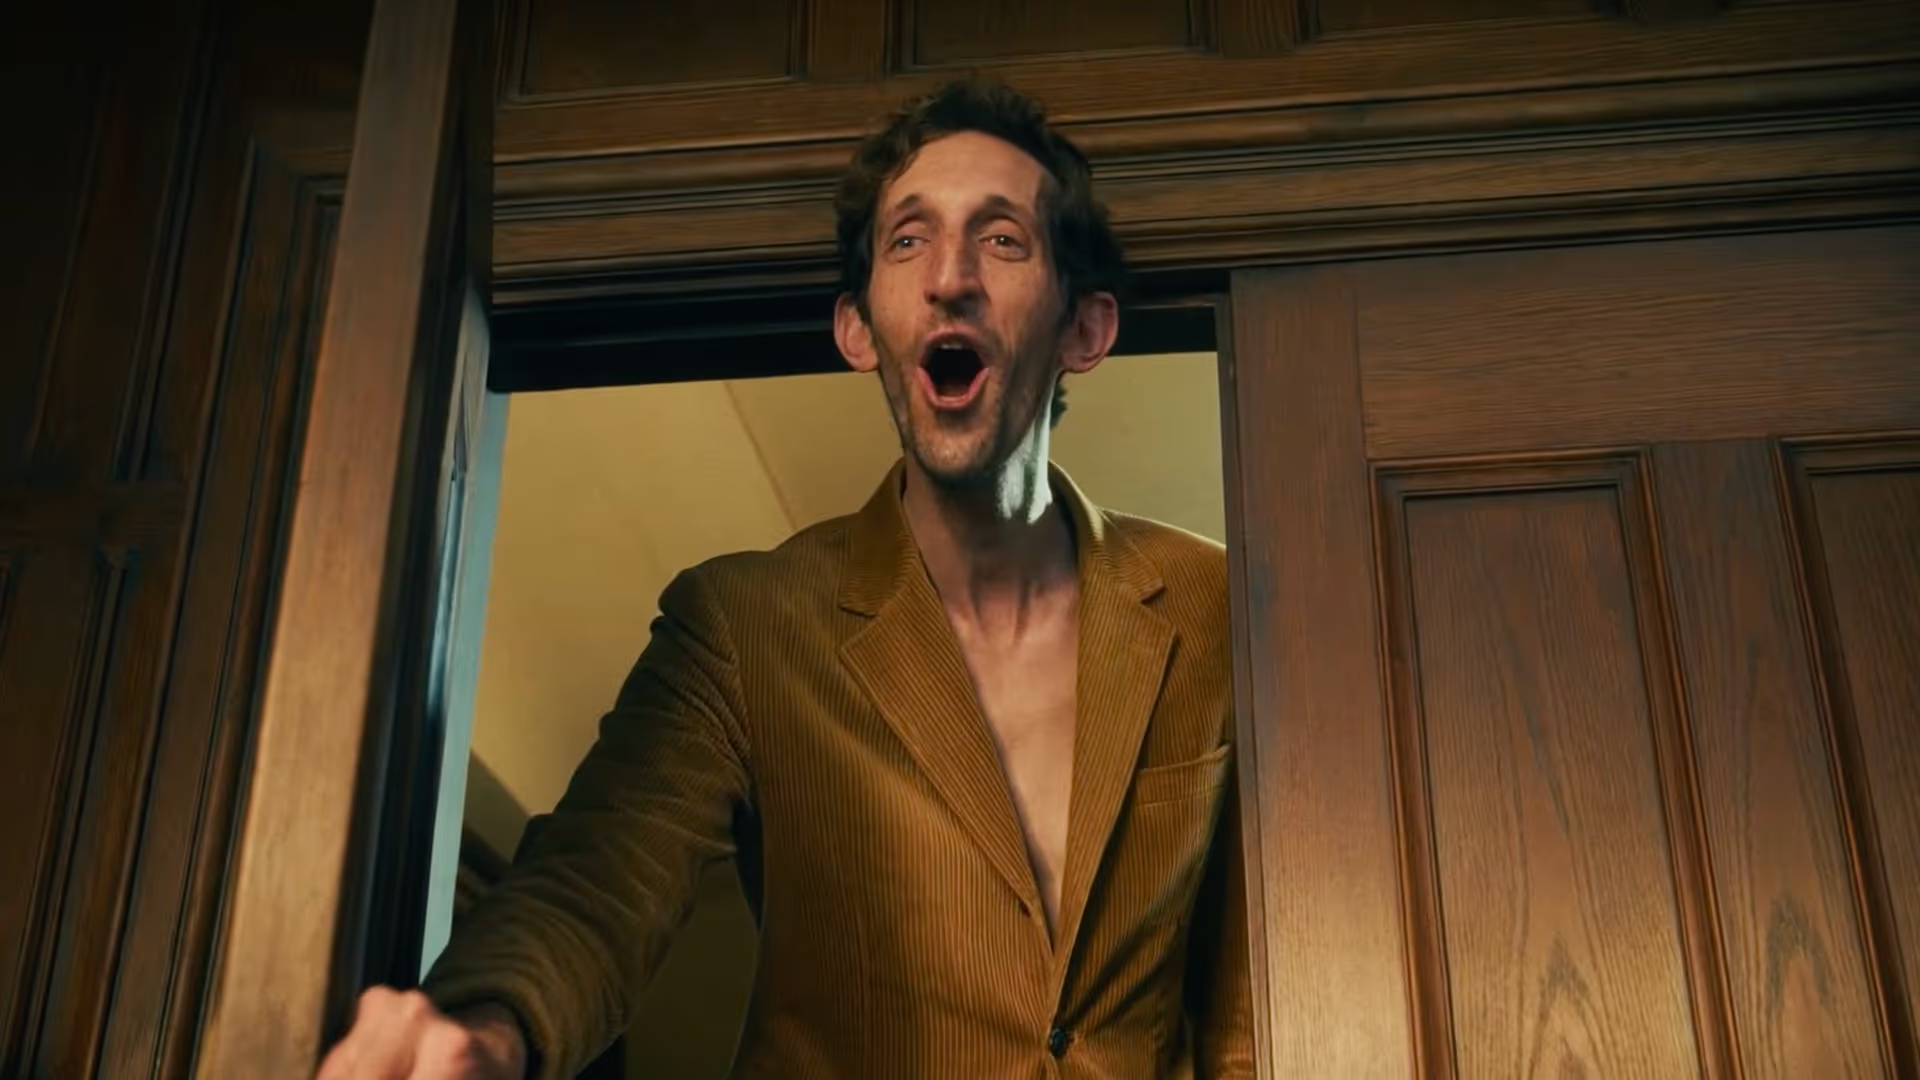
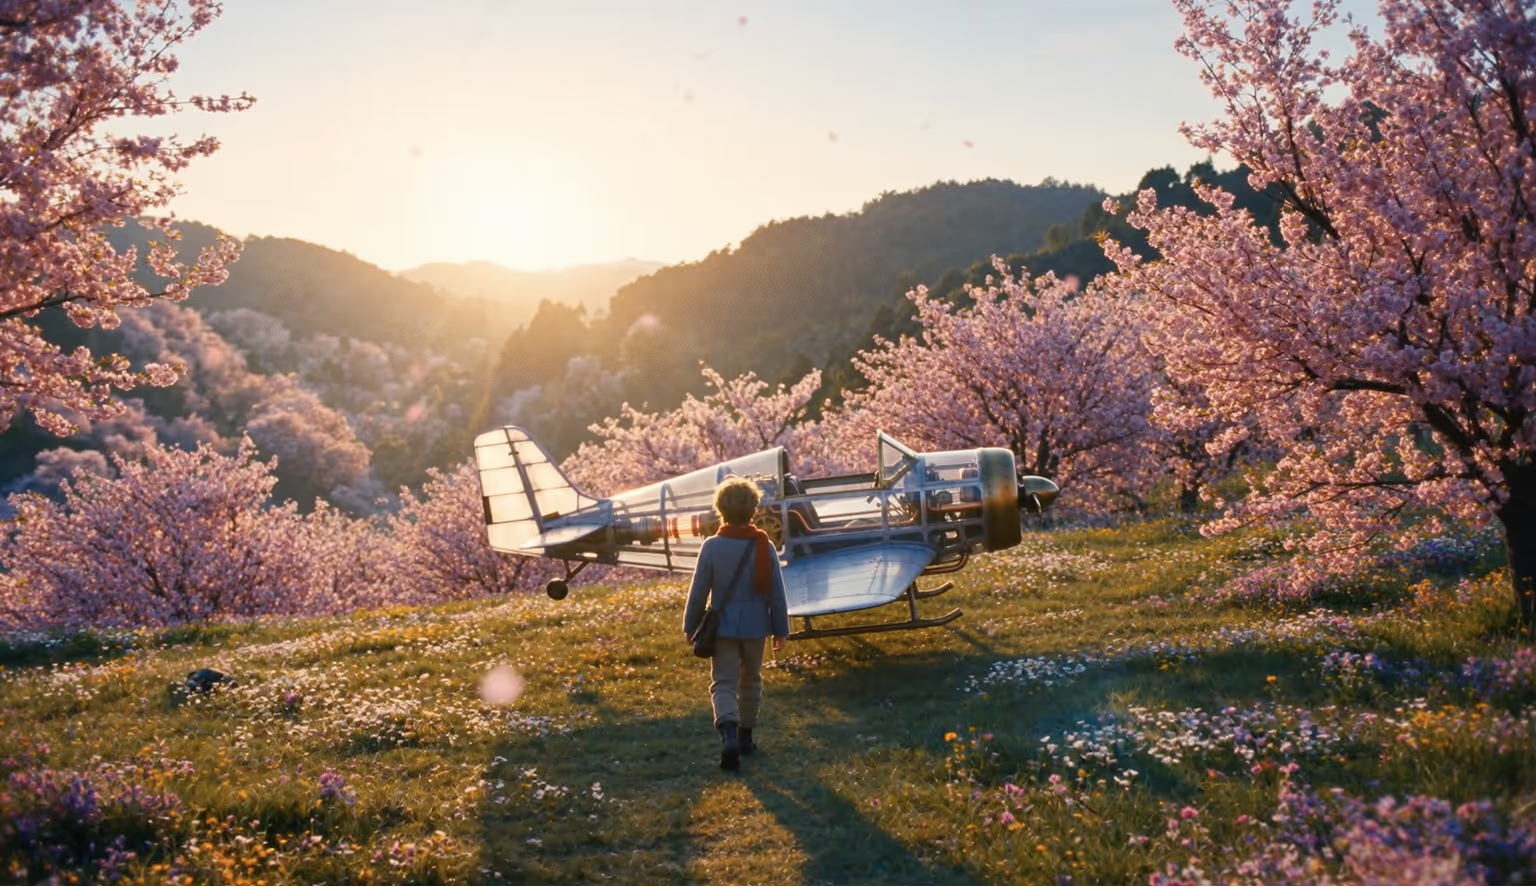
عندما يعمل، يستغرق العرض الناجح حوالي 30 دقيقة لإنتاج دقيقة كاملة من الفيديو. جودة المخرجات تبرر هذا الانتظار. زوايا الكاميرا تتغير بشكل طبيعي وتحترم الإطارات الرئيسية المحددة، الإضاءة طبيعية، والشخصيات لا تتمتع بالجودة الفارغة التي تجعل معظم توليدات الفيديو بالذكاء الاصطناعي تبدو بلا حياة. الأصوات متسقة عبر المشاهد، مع نبرة صحيحة تبقى حتى بعد القطع إلى عناصر أخرى.
عندما تعيد الكاميرا التركيز على شخصية بعد عرض شيء آخر، تعود الشخصية كما تركتها تمامًا. الخلفية تبقى مستقرة طوال الوقت، وعلى الرغم من وجود تشوهات وقطع أثرية، إلا أنها طفيفة. نقطة ضعف واحدة: النموذج لا يتعامل جيدًا مع النص داخل الفيديو. يمكنه إنتاج عناصر نصية أساسية، لكن لا تعتمد عليه لأي شيء يتطلب طباعة دقيقة على الشاشة.
إليك عينة من توليد تم فيه التعامل مع كل شيء تلقائيًا بواسطة النموذج.
الآن للجزء الأصعب. فشل أحد تسلسلات الاختبار لدينا ثلاث مرات متتالية. المحاولة الأولى استغرقت حوالي 45 دقيقة، استهلكت رصيدًا كما لو تم توليد فيديو كامل، وأنتجت نتيجة فارغة. أخبرنا chatbot أنه لم يولد شيئًا. اعترف بالخطأ وأعاد التشغيل.

بعد ساعة، لا شيء بعد. حاولنا مرة ثالثة. نفس النتيجة. ثلاث محاولات، خسارة كبيرة في الرصيد، وصفر لقطات. بحلول الوقت الذي استسلمنا فيه، كنا تقريبًا نفد رصيدنا بالكامل واضطررنا للمضي قدمًا.
هذا ليس خطأ بسيطًا عندما تدفع أموالًا حقيقية وتعمل ضمن جداول زمنية احترافية. الواجهة تعترف بأن الأخطاء تحدث. تجربتها مباشرة شيء مختلف، خاصة بالنظر إلى أنك ستحتاج إلى رصيد إيجابي لتنزيل فيديو إذا تم استهلاك رصيدك أثناء عملية التوليد.

في اختبارنا الأول مع كل شيء محدد تلقائيًا، ارتكبت خطأ مستخدم: أطعمت صورتين مرجعيتين دون تحديد أي شخصية يجب أن تستخدم أي صورة، وعينها النموذج بالعكس—الشخصية الذكورية (أنا) تم توليدها من المرجع الأنثوي (زوجتي)، والعكس صحيح.
انسَ تلك الصورة المؤلمة لي كامرأة، والفيديو الناتج ما زال ينتهي به الأمر ليكون أكثر فيديو طويل بالذكاء الاصطناعي تم توليده باستمرارية. حتى مع المراجع الخاطئة، حافظ النموذج على الاستمرارية البصرية والنغمية من مشهد إلى آخر. هذا يقول الكثير عن البنية الأساسية.
الدرس من كلتا التجربتين هو نفسه: أدوات الفيديو بالذكاء الاصطناعي العادية تفترض كل شيء عنك، مما يعني أنك لا تحتاج إلى التفكير كثيرًا—ولكن عليك أيضًا قبول ما يقررونه. PAI يمنحك التحكم. ومع هذا التحكم تأتي المسؤولية الكاملة عما تضعه.

بمجرد اكتمال الفيديو، تتيح لك علامة التبويب "المحرر" توجيه المراجعات بالكامل باللغة الطبيعية. أدخل عناصر في مشهد، احذفها، غيّر الألوان، اضبط الإضاءة، أعد صياغة الحوار، أو حدّث مزامنة الشفاه، وسيعيد النموذج العرض وفقًا لذلك. إنه يفهم حقًا ما تطلبه.
هذا ليس مرشح معالجة لاحقة. إنه مراجعة متكررة مدفوعة بالذكاء الاصطناعي على مستوى المشهد. القدرة على وصف نية تحريرية واستلام لقطات مصححة في المقابل تغير العلاقة الإبداعية بين المخرج ومادته تمامًا. هذه الميزة، أكثر من أي شيء آخر في PAI، تبدو وكأنها حيث قد يتجه تحرير الفيديو بالذكاء الاصطناعي في المستقبل القريب.
على سبيل المثال، بعد مشاهدة الفيديو الأول، طلبت من النموذج إصلاح خطأ الجنس باستخدام المراجع الصحيحة.
بمجرد المعالجة، تحول من هذا:

إلى هذا:


يسجل علامة التبويب "السجل" خطًا زمنيًا كاملاً لكل تفاعل: المطالبات، التعديلات، محاولات العرض، كل شيء.
للمبدعين الفرديين، يوفر سياقًا مفيدًا. للفرق، قد يكون طبقة تعاون حقيقية حيث يمكن للمستخدمين المختلفين رؤية كيفية توجيه الزملاء للنموذج، وفهم ما نجح وما لم ينجح، والمتابعة من سجل إبداعي مشترك.
سعر PAI هو 100 دولار مقابل 10,000 رصيد. في اختباراتنا، غطى 2,000 رصيد أربعة فيديوهات (واحد مكتمل، ثلاثة لا) بإجمالي أربع دقائق—شخصيتان تم توليدهما لكل فيديو مع تكرارات متعددة قبل العرض، تطوير القصة المصورة على مطالبات غنية ومفصلة، وحوالي جولتين من التحرير بعد العرض.
بشكل عام، يبدو PAI كأداة احترافية مبنية للأشخاص الذين يأخذون الفيديو بالذكاء الاصطناعي على محمل الجد. إنه بطيء، لا يرحم قلة الخبرة—يمكنه بصراحة استخدام برنامج تعليمي لطيف—وقادر على حرق ميزانيتك بسرعة كبيرة. الواجهة ليست مضمونة، والنظام سيعاقبك إذا دخلت غير مستعد.
بعد جلسة أولى قضيتها في تعلم كيف يفكر، أنتجت جولتنا الثانية من الاختبار نتائج مفاجئة وممتعة للغاية—النوع الذي يتطلب عادة تقنيات استبدال الوجه، وجولات من التجربة والخطأ، وتعديلات في مرحلة ما بعد الإنتاج.
لمنشئي الفيديو المحترفين، الذين تعتبر الاستمرارية وسلامة الملكية الفكرية والجودة السينمائية عناصر غير قابلة للتفاوض، PAI هو أفضل نظام فيديو طويل بالذكاء الاصطناعي متاح حاليًا. أصلح مشاكل الموثوقية، ولا شيء آخر يقترب، على الأقل في الوقت الحالي.
تلقّ إشعارات
مستقبل سرد القصص، في بريدك الإلكتروني.